

Şirket verisiyle çalışan "kendi ChatGPT'niz" tam olarak nedir?
Şirket verisiyle çalışan kendi ChatGPT'niz, sorulara kendi belgelerinizden ve sistemlerinizden yanıt veren, kurallarını kurumunuzun koyduğu bir asistandır: hangi kaynağı kimin görebileceğine, istemlerin nerede işleneceğine, neyin ne kadar süre kaydedileceğine siz karar verirsiniz. Yazıda "ChatGPT" bir kısaltma olarak geçiyor; aynı sorular üzerine kurabileceğiniz her genel amaçlı asistan ya da dil modeli için geçerli.
Tedarikçi hangi adı verirse versin, bu sistemlerin üç parçası vardır. Model yanıtı yazar. Getirme katmanı, soru sorulduğu anda belgelerinizdeki ilgili pasajları bulur; bu yaklaşımın adı RAG'dir (retrieval-augmented generation, bilgi getirme destekli üretim). Kontrol katmanı ise oturum açmayı, yetkileri, kayıtları, saklama sürelerini ve kullanıcıya gösterilen kaynağı yönetir. Satın alma kararlarının çoğu aslında ikinci ve üçüncü parçayla ilgilidir. Modeller belli ölçüde birbirinin yerine geçebilir; verinizin nasıl bağlandığı, nasıl filtrelendiği ve nasıl yönetildiği geçemez.
Genellikle birlikte istenen iki ihtiyacı birbirinden ayırmak da işinizi kolaylaştırır. Birincisi, çalışanlar için genel bir yazım ve analiz yardımcısıdır: e-posta taslağı hazırlamak, yapıştırılan bir raporu özetlemek, bir paragrafı çevirmek. İkincisi, şirketinizi tanıyan bir asistandır: "Seyahat politikamız hafta sonu uçuşları hakkında ne diyor?" ya da "Hangi müşteri sözleşmelerinde kontrol değişikliği maddesi var?" gibi soruları kendi kaynaklarınızdan yanıtlar ve her yanıtın nereden geldiğini gösterir. İlki büyük ölçüde bir lisans ve kullanım politikası meselesidir. İkincisi bir veri projesidir ve bu rehberin asıl konusu odur.
Kurumsal ChatGPT için hangi seçenekler var?
Üç ana yol var ve birçok kurum sonunda bunlardan ikisini birlikte kullanıyor.
- Hazır bir asistanın kurumsal (SaaS) planı. ChatGPT'nin kurumsal planları, Microsoft Copilot, Google Workspace içindeki Gemini ve benzerleri. Lisans satın alır, tedarikçinin bağlayıcılarını e-posta, dosya ve yazışma sistemlerinize bağlar, kullanıcıları yönetim panelinden yönetirsiniz.
- Bulut model API'si üzerinde kendi uygulamanız. Getirme ve kontrol katmanlarını siz ya da bir tedarikçi kurar; model, kendi bulut aboneliğinizde yönetilen bir hizmet olarak çalışır. Microsoft Foundry'deki bir model dağıtımı buna örnektir.
- Şirket içi kurulum. Açık ağırlıklı bir model, kendi getirme katmanınızla birlikte, kendi veri merkezinizdeki ya da denetiminizdeki özel sunucularda çalışır. Siz karar vermedikçe hiçbir veri ağınızın dışına çıkmaz.
| Soru | SaaS kurumsal plan | Bulut API'si üzerinde kendi uygulamanız | Şirket içi kurulum |
|---|---|---|---|
| İstemler nerede işleniyor? | Tedarikçinin bölgelerinde, onun koşullarıyla | Seçtiğiniz bölge ve dağıtım türünde | Kendi sunucularınızda |
| Yetkiler nasıl uygulanıyor? | Tedarikçinin bağlayıcıları ve mevcut dosya izinleriniz üzerinden | Yetki filtresini siz tasarlarsınız | Yetki filtresini siz tasarlarsınız |
| Hangi kaynakları kullanabiliyor? | Tedarikçinin bağlayıcı sunduğu kaynakları | Bağlayıcı yazabildiğiniz her kaynağı | Bağlayıcı yazabildiğiniz her kaynağı |
| Yanıt ve kaynak gösterimi üzerinde kontrol | Ürün ayarlarıyla sınırlı | Tam | Tam |
| İşletme yükü | Düşük | Orta | Yüksek: donanım, kapasite, güncellemeler |
| Maliyetin yapısı | Kullanıcı başına lisans | Geliştirme maliyeti ve kullanım bedeli | Geliştirme maliyeti, donanım ve işletme |
| En iyi uyduğu durum | Veri tek bir ofis paketinde ve izinler düzenli | Yanıtlar iş sistemlerinden gelmeli ya da kendi kalite kurallarınıza uymalı | Veri yasa, sözleşme veya politika gereği kurum dışına çıkamıyor |
Önemli ayrıntılar için tedarikçinin pazarlama sayfasını değil, teknik belgelerini okuyun. Microsoft'un Copilot için veri, gizlilik ve güvenlik sayfası, istemlerin, yanıtların ve Microsoft Graph üzerinden erişilen verilerin temel modelleri eğitmek için kullanılmadığını, Copilot'un da yalnızca kullanıcının en az görüntüleme yetkisi olduğu kurum verisini gösterdiğini belirtiyor. Aynı sayfa, AB dışındaki müşterilerin sorgularının ABD'de, AB'de veya başka bölgelerde işlenebileceğini de yazıyor; Türkiye'deki bir şirket için bu doğrudan bir yurt dışına aktarım sorusudur. Google'ın Workspace'te üretken yapay zeka gizlilik merkezi de model eğitimi ve mevcut erişim kontrolleri konusunda benzer taahhütler içeriyor. Bulut API'si yolunda Microsoft'un Azure'un sattığı modeller için veri gizliliği sayfası, Global veya Data Zone dağıtım türü seçilmedikçe istemlerin sizin belirlediğiniz coğrafyada işlendiğini açıklıyor. Aynı sayfaya göre kötüye kullanım izlemesinin işaretlediği içerik, değiştirilmiş izleme için onay almadıysanız insan incelemesi amacıyla saklanabiliyor. Kişisel veri değerlendirmeniz tam olarak bu ayrıntıları soracaktır.
Şirket verisi üzerinde RAG, ChatGPT'ye dosya yüklemekten farklı mı?
Evet. Bir sohbete dosya yüklediğinizde model tek bir konuşma için tek bir belge görür; RAG ise asistanı kaynaklarınıza kalıcı olarak bağlar, onları güncel tutar ve her soruda bu kullanıcının hangi pasajları görebileceğine karar verir.
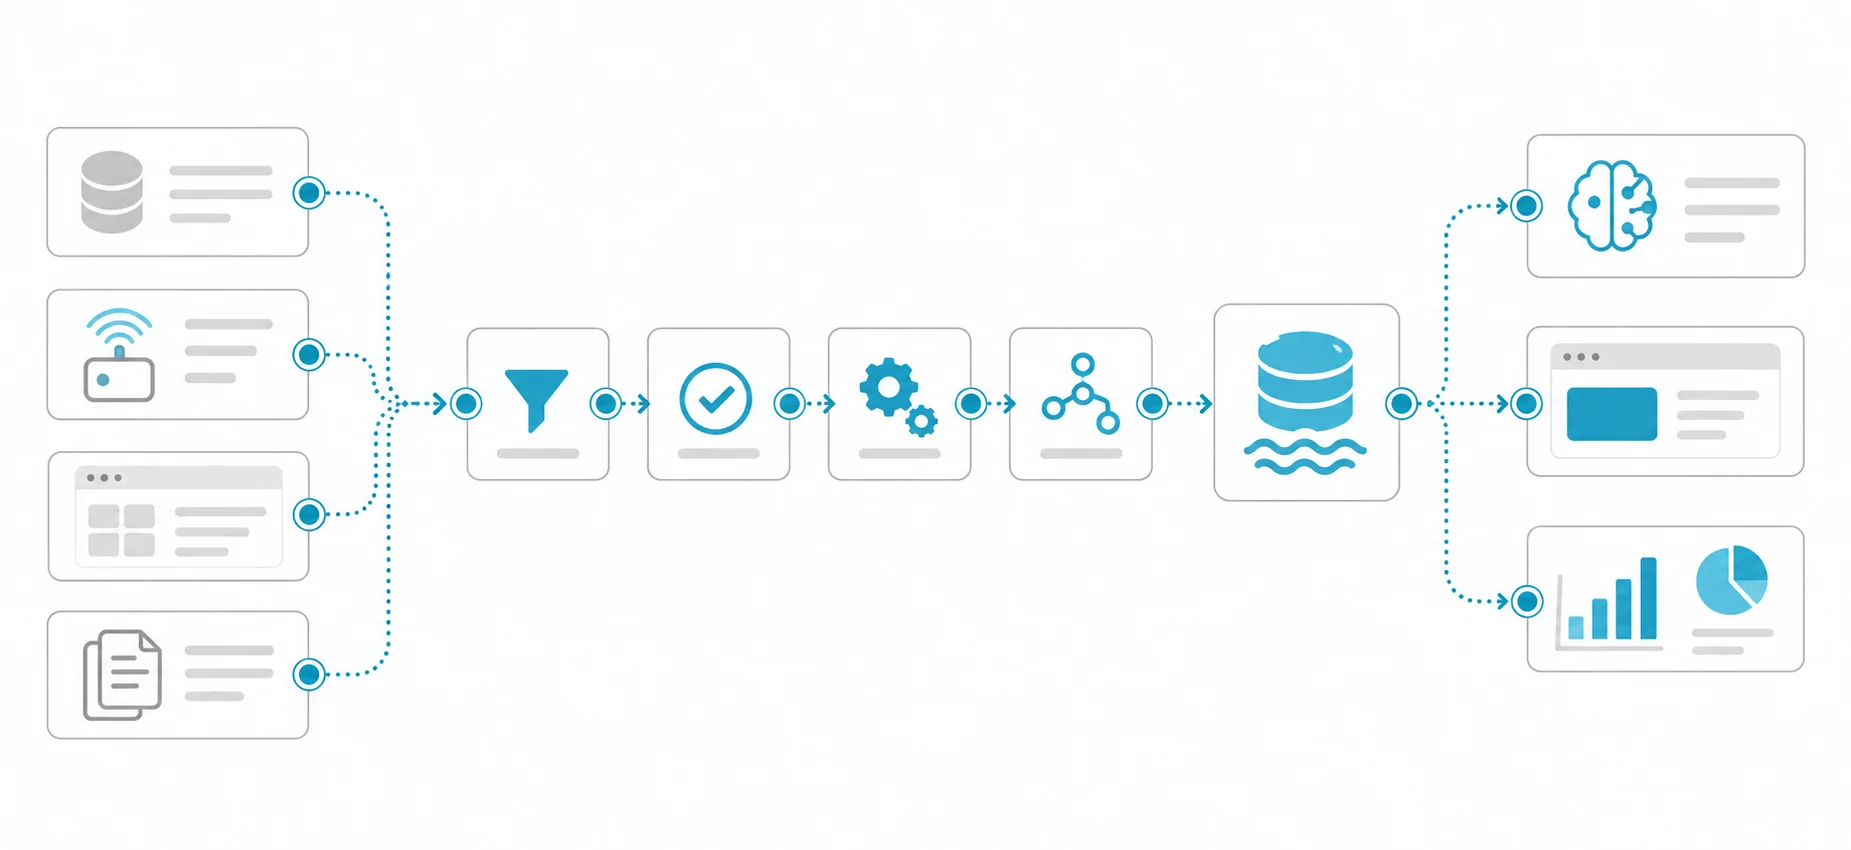
Bir RAG hattı birkaç aşamadan oluşur ve kalite her birinde kazanılır ya da kaybedilir:
- Bağlayıcılar ortak sürücüden, SharePoint'ten, belge yönetim sisteminden, wiki'den, talep sisteminden ya da ERP'den belgeleri, her belgenin izinleriyle birlikte okur.
- Ayrıştırma PDF'leri, taramaları, hesap tablolarını ve sunumları, başlıkları ve tabloları bozmadan temiz metne çevirir. Taranmış belgelerin önce OCR'dan geçmesi gerekir.
- Dizinleme belgeleri pasajlara böler ve hem anahtar kelime hem anlam araması için saklar; böylece ürün kodu ya da madde numarası gibi tam ifadeler kaybolmaz.
- Yetki filtresi kullanıcının kaynak sistemde açamadığı her pasajı, aramanın kendi içinde eler.
- Üretim aşamasında modele yalnızca seçilen pasajlar verilir ve yanıtı bunlardan kurması istenir.
- Kaynak gösterme her ifadeyi geldiği pasaja bağlar. Destekleyen pasaj yoksa asistan tahmin yürütmek yerine yanıtı bulamadığını söyler.
Asistanı gerçek işte kullanılabilir kılan adım kaynak göstermedir; çünkü insanlar yanıta güvenmek zorunda kalmadan onu saniyeler içinde kontrol edebilir. Hatson Tech'in hukuk bürolarında durum tespiti (due diligence) ve sözleşme inceleme için geliştirmekte olduğu LegalTech ürünü Caseon bu ilkenin bir örneği: her yanıt dayandığı belge alıntısıyla birlikte gösterilir, kaynakları inceleyip işi onaylayan avukattır. Yaklaşımı Caseon vaka çalışmasında anlattık. Aynı tasarım kararı bir insan kaynakları politika asistanı ya da teknik destek asistanı için de geçerli. Kullanıcı kaynağı göremezse ya aracı kullanmayı bırakır ya da, daha kötüsü, yanıtları kontrol etmeyi bırakır.
Yaygınlaştırmadan önce hangi KVKK soruları yanıtlanmalı?
En azından şunlar: veri sorumlusu kim, veri işleyen kim; kişisel veri nerede işleniyor ve hangi dayanakla aktarılıyor; çalışanlara ve müşterilere ne anlatılıyor; ne saklanıyor ve ne kadar süreyle; tedarikçi verinizi hizmeti sunmanın ötesinde bir amaçla kullanıyor mu?
Kişisel Verileri Koruma Kurumu'nun Kasım 2025'te yayımladığı Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi, 6698 sayılı Kanun'u bu sistemlere uyguluyor. Rehberin iki tespiti şirket asistanını doğrudan ilgilendiriyor. Birincisi, Türkiye'de faaliyet gösteren bir kurum üretken yapay zeka sistemini yurt dışında yerleşik bir hizmet sağlayıcı üzerinden kullanıyor ve bu yüzden kişisel veri yurt dışına aktarılıyorsa, aktarımın Kanun'un 9. maddesine ve 2024 tarihli yurt dışına aktarım yönetmeliğine uygun yapılması gerekir. İkincisi, rehber sistemi kullanmak için yapılan işleme ile modelleri geliştirmek veya iyileştirmek için yapılan işleme hakkında ayrı ve açık aydınlatma yapılmasını öneriyor. 6698 sayılı Kanun'un 9. maddesi aktarıma yeterlilik kararı varsa ya da maddede sayılan uygun güvencelerden biri sağlanırsa izin veriyor. Bu güvencelerden biri Kurul'un ilan ettiği standart sözleşmedir ve imzadan itibaren beş iş günü içinde Kurum'a bildirilmesi gerekir. İkisi de yoksa aktarım ancak arızi olmak kaydıyla 6. fıkradaki hallere dayanabilir.
Aşağıdaki kontrol listesini hukuk ve bilgi güvenliği ekiplerinizle birlikte doldurun. Bu bir hukuki görüş değil; ilk birim canlıya geçmeden önce yazılı yanıtı olması gereken soruların listesi.
| Soru | Neden önemli? | Ne istenmeli? |
|---|---|---|
| Asistan hangi kişisel verileri görecek? | Sözleşmeler, özlük dosyaları ve destek kayıtları çoğu zaman ad, kimlik numarası ve sağlık bilgisi içerir | Kişisel veri sütunu olan bir kaynak envanteri |
| Veri sorumlusu kim, veri işleyen kim? | Kurum'a ve ilgili kişilere kimin hesap vereceğini belirler | Veri işleme sözleşmesi ve ekleri |
| İstemler, dizinler ve kayıtlar nerede işleniyor ve saklanıyor? | Yurt dışında işleme 9. maddeyi devreye sokar | Bölgeler, dağıtım türü ve alt işleyen listesi |
| Aktarımın dayanağı ne? | Yeterlilik kararı, uygun güvence veya arızi istisna; her birinin ayrı koşulları var | İmzalı standart sözleşme ve bildirim kaydı ya da belgelenmiş alternatif |
| Tedarikçi verinizle model eğitiyor ya da veriyi inceliyor mu? | Model eğitimi ve insan incelemesi ayrı işleme amaçlarıdır | Pazarlama sayfası değil sözleşme maddesi; kötüye kullanım izleme ayarları |
| İstemler, yanıtlar ve kayıtlar ne kadar saklanıyor? | Saklama süresi amaca ve saklama-imha politikanıza uymalı | Ayarlanabilir saklama süresi, silme prosedürü, kayıtların içeriği |
| Çalışanlar ve müşteriler aydınlatıldı mı? | Kanun'un 10. maddesindeki aydınlatma yükümlülüğü | Güncellenmiş aydınlatma metinleri; veri model iyileştirmede kullanılacaksa ayrı metin |
| Özel nitelikli veriler hariç tutuldu ya da korundu mu? | Sağlık, biyometrik ve benzeri veriler daha sıkı şartlara tabidir | Hariç tutulan klasörler, maskeleme kuralları, ek önlemler |
| İlgili kişi başvuruları nasıl karşılanacak? | Kişi hakkında hangi verinin tutulduğunu sorabilir ya da silinmesini isteyebilir | Dizin ve kayıtlar genelinde arama ve silme imkânı |
"Nerede işleniyor?" sorusunun yanıtı "yurt dışında" ve aktarım dayanağı belirsizse, bu projeden vazgeçmek için değil, mimariyi bilinçli seçmek için bir nedendir: bazı kaynaklar bulut hizmetine gidebilir, bazıları kendi sunucularınızdaki bir modelde kalabilir. Kurulum tarafını kurum içi ve egemen yapay zeka rehberimizde daha ayrıntılı ele aldık.
Yetkiler nasıl çalışır ve projeyi neden belirler?
Şirket asistanı yalnızca soruyu soran kişinin kaynak sistemde açabildiği pasajları kullanabilir. Geri kalan her şey bu kuraldan türer ve gerçek bir projede emeğin büyük kısmı bu kuralı gerçekten sağlamaya gider.
SaaS asistanda yetkiler mevcut dosya paylaşımlarınızdan gelir. Bu pratiktir ama bir sonucu vardır: yıllar önce "şirketteki herkesle" paylaşılmış her klasör artık gündelik dille aranabilir hale gelir. SaaS bir asistanı açmadan önce geniş paylaşım bağlantılarını, bordro ve hukuk gibi hassas klasörleri gözden geçirin, hassasiyet etiketlerinin kullanılıp kullanılmadığını kontrol edin. Kendi uygulamanızda ise yetki filtresini siz kurarsınız: her pasaj, onu okuyabilecek kullanıcı ve grupların kimliklerini taşır; arama da sıralamadan önce kullanıcının güncel gruplarını uygular. Ayrıntıları ve bir sızıntı test planını kurumsal RAG'de yetki duyarlı arama yazımızda anlattık.
OWASP'ın büyük dil modeli uygulamaları için 2025 risk listesi iki hata biçimini de adıyla anar. Vektör ve embedding zayıflıkları maddesi, aynı vektör veritabanını paylaşan kullanıcılar arasında bağlam sızıntısını anlatır ve yetki duyarlı vektör depolarıyla veri kümelerinin sıkı mantıksal ayrımını önerir. Hassas bilginin ifşası maddesi ise veri kaynaklarına en az yetkiyle erişimi ve saklama ile silme konusunda açık politikaları önerir. Canlıya çıkmadan önce yapılacak pratik bir test: aynı soruyu sıradan bir çalışan, bir yönetici ve bir misafir hesabıyla sorun; yalnızca son yanıtları değil, ham arama sonuçlarını da karşılaştırın.
Bizim durumumuza hangi seçenek uyar?
Aşağıdaki soruları dürüstçe yanıtlayın. Yanıtların örüntüsü çoğu zaman tek bir yolu ya da bilinçli bir birleşimi gösterir.
| Soru | Yanıt evetse yöneleceğiniz yol |
|---|---|
| İlgili belgelerin çoğu, izinlerine güvendiğiniz tek bir ofis paketinde mi? | SaaS kurumsal plan |
| Asıl ihtiyaç şirket bilgisi değil, genel yazım yardımı mı? | SaaS kurumsal plan ve bir kullanım politikası |
| Yanıtlar ERP'den, CRM'den, belge yönetim sisteminden ya da özel bir veritabanından mı gelmeli? | Bulut API'si üzerinde kendi uygulamanız |
| Yanıtlarda belirli bir kaynak gösterim biçimi, Türkçe kalite kontrolleri ya da onay adımı gerekiyor mu? | Kendi uygulamanız |
| Yasa, bir müşteri sözleşmesi ya da iç politika verinin kurum dışına çıkmasını yasaklıyor mu? | En azından bu kaynaklar için şirket içi kurulum |
| Yurt dışındaki bir bulut hizmeti için aktarım dayanağı hâlâ belirsiz mi? | Şirket içi kurulum ya da belirsizlik giderilene kadar hibrit yapı |
| Asistan kayıt oluşturmak, talep açmak gibi işlemler de yapmalı mı? | Ajan katmanı ve insan onayı olan kendi uygulamanız |
| Sunucuları işletecek ve modelleri güncelleyecek kimse yok mu? | Bir tedarikçi işletmeyi üstlenmiyorsa şirket içi kurulumdan kaçının |
Tablo sizi iki yol arasında bırakıyorsa, yanlış bir yanıtı kimin fark edeceğini sorun. Kimse kontrol etmiyorsa kaynak gösterme ve düzenli örnek incelemesi, model seçiminden daha önemli hale gelir.
Varsayımsal örnek: tek şirket, iki asistan
Bu bir müşteri hikâyesi değil, varsayımsal bir örnektir. Yaklaşık 400 çalışanı olan bir üretici, "şirketimizi bilen bir ChatGPT" istiyor. İlk görüşme üç ayrı ihtiyacı ortaya çıkarıyor:
- Ofis çalışanları e-posta taslağı ve rapor özeti için yardım istiyor. Malzemenin çoğu gizli değil.
- Üretim mühendisleri kalite prosedürlerinden ve iş talimatlarından yanıt istiyor. Bu belgeler SharePoint'te, birim bazında düzenli izinlerle duruyor.
- Satış ekibi, belge yönetim sistemindeki müşteri sözleşmeleri üzerinde soru sormak istiyor. Sözleşmelerin bir kısmında verinin şirket dışında işlenmesini kısıtlayan gizlilik maddeleri var, imza sayfalarında da kişisel veri bulunuyor.
Her ihtiyacı tablodan geçirmek net bir ayrım ortaya koyuyor. Ofis yazışmaları ve prosedür asistanı, prosedür kütüphanesinin izinleri temizlendikten ve çalışanlara neyi yapıştırmamaları gerektiğini anlatan kısa bir kullanım politikası yayımlandıktan sonra SaaS kurumsal plana gidiyor. Sözleşme asistanı ise şirketin kendi sunucularında çalışan açık ağırlıklı bir model üzerinde ayrı bir uygulama oluyor; yetki filtresi belge yönetim sisteminden eşleniyor ve her yanıtta kaynak madde gösteriliyor. Hukuk ekibi SaaS plan için KVKK kontrol listesini, işleme bölgeleri ve aktarım dayanağı dahil olmak üzere onaylıyor; sözleşmeler için şirket içi asistan aktarım sorusunu tümüyle ortadan kaldırıyor. Pilot, tek bir satış ekibi ve bu ekipten toplanan 50 gerçek soruyla başlıyor; her soru beklenen yanıtı ve göstermesi gereken maddeyle birlikte yazıya geçiriliyor.
Mimariyi belirleyen şey herhangi bir modelin kalitesi değil, verinin nerede durduğu ve sözleşmelerin neye izin verdiği oldu.
Makul bir yaygınlaştırma planı nasıl olmalı?
Asistanı herkes için bir anda açmak yerine, her birinin net bir çıkış ölçütü olan aşamalarla ilerleyin.
- Envanter ve politika. Kaynakları, sahiplerini, izinlerini ve içerdikleri kişisel veriyi listeleyin. Çalışanların bugün hangi yapay zeka araçlarını kullandığını öğrenin ve kısa bir kabul edilebilir kullanım politikası yayımlayın.
- Altın soru seti. Gelecekteki kullanıcılardan gerçek sorular toplayın; her birini beklenen yanıt ve kaynağıyla yazın. Bu set kabul testiniz olur.
- Pilot. Tek birim, bir ya da iki kaynak. Doğru pasajın getirilip getirilmediğini, kaynak atıflarının doğruluğunu, asistanın ne sıklıkla doğru biçimde "bilmiyorum" dediğini ve yetki testlerinin geçip geçmediğini ölçün.
- Genişleme. Kaynakları ve birimleri birer birer ekleyin, her değişiklikten sonra soru setini yeniden çalıştırın.
- Eğitim. Kullanıcılara kaynak atıflarını nasıl okuyacaklarını ve yanlış bir yanıtı nasıl bildireceklerini gösterin. Benimsenme, modelden çok buna bağlıdır.
- İşletme. Dizinin güncelliğini, yetki eşitlemesini, yanıtlanan soru başına maliyeti ve kullanıcı geri bildirimini izleyin. Model sürümü her değiştiğinde soru setini yeniden çalıştırın.
Sık yapılan hatalar
- Kimin hangi klasörü görebildiğini temizlemeden lisans satın almak.
- Sistemi kendi soru setiniz yerine tedarikçinin demosuyla değerlendirmek.
- Kontrol edilmesi gereken işlerde kaynaksız yanıtları kabul etmek.
- Tedarikçinin pazarlama sayfasını veri işleme sözleşmesi yerine koymak.
- "Ne olur ne olmaz" diyerek, iş amacı olmayan ve kişisel veriyle dolu arşivler dahil her şeyi dizinlemek.
- Kayıtları unutmak: istemler ve yanıtlar da kişisel veridir ve kendi saklama süreleri olmalıdır.
Hatson Tech bu işe nasıl yaklaşıyor?
Kendi belgeleriniz ve sistemleriniz üzerinde çalışan asistanları, bulutta ya da kendi sunucularınızda, kurumsal RAG ve anlamsal arama çözümlerimiz kapsamında kuruyoruz. Her yanıt kaynağını gösterir, yetkiler aramanın içinde uygulanır ve altın soru seti kabul ölçütlerinin parçasıdır. Mevzuat tarafı için KVKK üretken yapay zeka rehberimize bakabilirsiniz. İlk görüşme ve yazılım projelerindeki keşif çalışması ücretsizdir. Hazırlık için aklınızdaki kaynakların bir listesini ve ekiplerinizin her hafta sorduğu birkaç soruyu getirmeniz yeterli.